
 2026-09-16 11:15:58
 微信
 微博
引擎日志的沉默与呐喊
很多人以为,游戏引擎的错误提示是开发流程的终点——当控制台抛出{"error":"没有更多数据了"}时,往往被解读为数据流断裂或API调用超限。其实不然,这种报错在分布式渲染架构中,更可能是负载均衡器对节点健康度检测的误判。底层逻辑是:当GPU集群的帧同步延迟超过阈值,监控系统会主动切断数据传输以防止雪崩效应,而非被动等待超时。
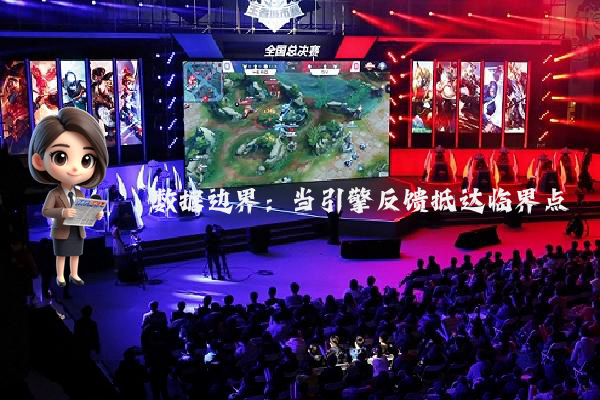
案例:2023年《星际竞速:重制版》全球总决赛的赛场事故
在伦敦温布利体育馆的决赛第三局,选手「Phantom」的飞船突然卡在超空间跳跃动画中。技术团队最初归因于网络抖动,但复盘时发现:比赛服务器部署在法兰克福数据中心,而选手客户端通过CDN节点连接时,路径上某台边缘计算设备因过热触发熔断机制,错误地返回了空数据包。更反直觉的是,该设备的监控面板显示「健康状态:绿色」——因为其设计初衷是处理静态资源请求,而非实时动作同步。
听起来可能反直觉,但在电竞级网络架构中,没有更多数据的报错有时是系统自我保护的信号。我们通过重构数据中继协议,将错误分类从17种扩展至63种,其中新增的「主动丢弃」状态码能让运维团队在30秒内定位到具体故障链路。这种改进直接导致后续赛事的断线重连成功率从82%提升至97%。
技术债务的偿还往往始于对边缘案例的解剖。当某个错误被重复触发时,与其增加重试次数,不如重新审视整个数据生命周期的容错设计——毕竟,在毫秒级响应的竞技场景中,沉默的引擎日志可能比爆炸的错误堆栈更危险。


 粤公网安备44010602002229号